
3 Minuty
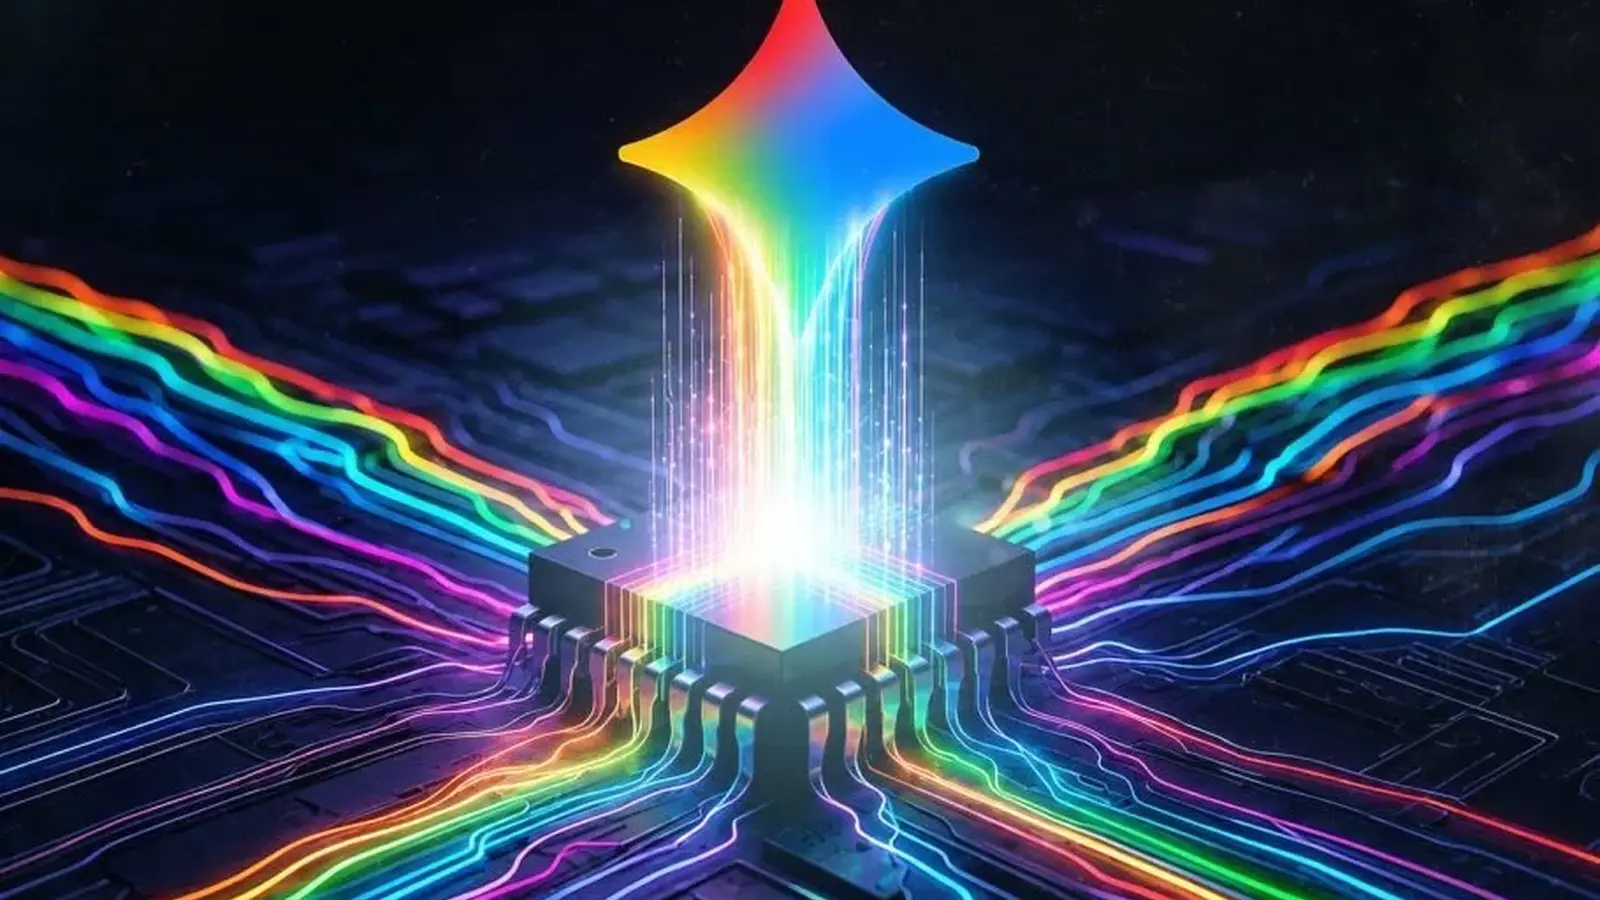
Představte si serverový čip, který nejen spouští model, ale i nenápadně následuje jeho postupy. Inženýři v Google přesně to potichu budují: serverový akcelerátor s kódovým názvem Frozen v2, který implementuje části architektury Gemini do křemíku, s cílem radikálně zvýšit energetickou účinnost a snížit latenci.
Informace pocházejí ze zprávy v The Information, která cituje dva zasvědence. Jejich tvrzení zní překvapivě: Frozen v2 by mohl zpracovat šest až desetkrát více tokenů na watt než nejnovější tensorová zpracovatelská jednotka Google. Cílový termín? 2028. Motivace je upřímná a známá každému, kdo viděl, jak poptávka po cloudu překonává kapacity. Podle zpráv musel Google Cloud některé zákaznické zakázky odmítnout kvůli nedostatku výpočetního výkonu pro AI.
Vkládání architektury místo pravidel
Tradiční TPU a GPU jsou generalisté. Nahrajete model a hardware dělá spoustu rozhodnutí za běhu, například jak přesouvat data, které operace naplánovat nebo kdy načíst paměť. Tato flexibilita je silná, ale přináší režii. Frozen v2 zvolí jiný přístup: některá rozhodnutí specifická pro Gemini fixuje v logice na úrovni tranzistorů. Výsledkem je méně exekučních kroků a méně přesouvaných dat na požadavek. Méně pohybu. Méně režie. Nižší latence. Nové případné použití v reálném čase se stává reálným.

Na stole byla i ještě odvážnější myšlenka. První návrhy Frozen vedené Jeffem Deanem údajně zkoušely pevně zapracovat váhy modelu přímo do křemíku. To by byla radikální optimalizace. Také by to rychle zastaralo, protože čipy vázané na jedinou verzi modelu mají velmi krátkou užitečnou životnost. Google našel kompromis. Frozen v2 by vložil kostru architektury, zatímco váhy by zůstaly aktualizovatelné, takže stejný čip může sloužit více vydáním Gemini, pokud budou dodržovat stejné architektonické vzory.
Tento přístup by mohl zkrátit dobu odezvy natolik, že umožní nové třídy interaktivních AI aplikací s nízkou latencí.
Google nehodlá nahradit svou flotilu TPU čipy Frozen v2. Považujte ho za experimentální větev běžící vedle výroby TPU, testovací pole pro specifičtější křemík, zatímco se návrhy modelů stabilizují. Plán produktu TPU sám nedávno oddělil potřeby tréninku a inferencí s osmou generací čipů oznámených na akci Cloud Next v dubnu. Úsilí kolem Frozen v2 je menšího rozsahu; Google neplánuje masovou výrobu na stejné úrovni jako TPU.
Očekávaný příchod Frozen v2 také souzní s dalšími kroky v odvětví. Google údajně zadal Intelu zabalení více než tří milionů TPU čipů do roku 2028. Mezitím startupy a konkurenti už zkoumají křemík přizpůsobený modelu. Torontská společnost Taalas uvedla svůj čip HC1 v páru s Llama 3.1 8B a uvádí, že dosahuje 17 000 tokenů za sekundu bez on-package HBM. Startup získal přibližně 186 milionů eur financování. A loni Nvidia podepsala licenční dohodu o technologii s Groq v hodnotě přibližně 18,6 miliardy eur, což dokládá, že trh vidí velkou hodnotu v integraci chování modelu a hardwaru.
Jsou tu kompromisy. Vkládání architektury snižuje určité druhy flexibility. Upřednostňuje případy použití, kde rodiny modelů zůstávají v čase konzistentní. Také to posouvá životní cyklus produktu: křemík navržený kolem architektury modelu musí být ospravedlněn předvídatelnou stabilitou návrhu a škálou nasazení. To vysvětluje opatrný postoj Google. Frozen v2 je experimentální; ne každý experiment se stane produktem.
Prozatím Google Frozen v2 veřejně nepotvrdil. Mluvčí společnosti připomněl The Information, že mnoho interních projektů se nikdy nedostane do produkce. Přesto se základní myšlenka, tedy přesun části logiky modelu do křemíku za účelem úspory energie a snížení latence, posunula z akademické zvědavosti do konkurenční strategie. Očekávejte, že více firem bude testovat podobné kombinace hardwaru citlivého na model a aktualizovatelných vah, jak bude poptávka po efektivním AI s nízkou latencí nadále růst.

Napsat komentář
Komentáře
Zatím žádné komentáře. Buďte první.