
Gemini 4 Carbon od Googlu snižuje náklady na vykonání jednoho úkolu na necelých 16 USD, méně než na třetinu toho, co stojí Anthropicův Claude Opus 5.5, který podle benchmarku GDPx od SemiAnalysisu vychází přibližně na 51 USD za úkol.
Žebříček GDPx řadí Opus 5.5 na první místo a Gemini 4 Carbon těsně za ním v hrubém skóre; Gemini 4 Carbon nezískal prvenství, ale kombinuje výkon blízký lídrovi trhu s výrazně nižšími náklady na úkol, což novému modelu Googlu dává jasnou hodnotovou pozici.
GDPx porovnává průlomové modely od Googlu, OpenAI, Anthropic a Meta tím, že zohledňuje skóre modelu a náklady na vykonání úkolu. Metoda používá 206 úloh pokrývajících finance, materiálové vědy, kybernetickou bezpečnost, softwarové inženýrství, právo a biologii, takže výsledky nejsou omezeny na obecné generování textu nebo odpovídání na běžné otázky.
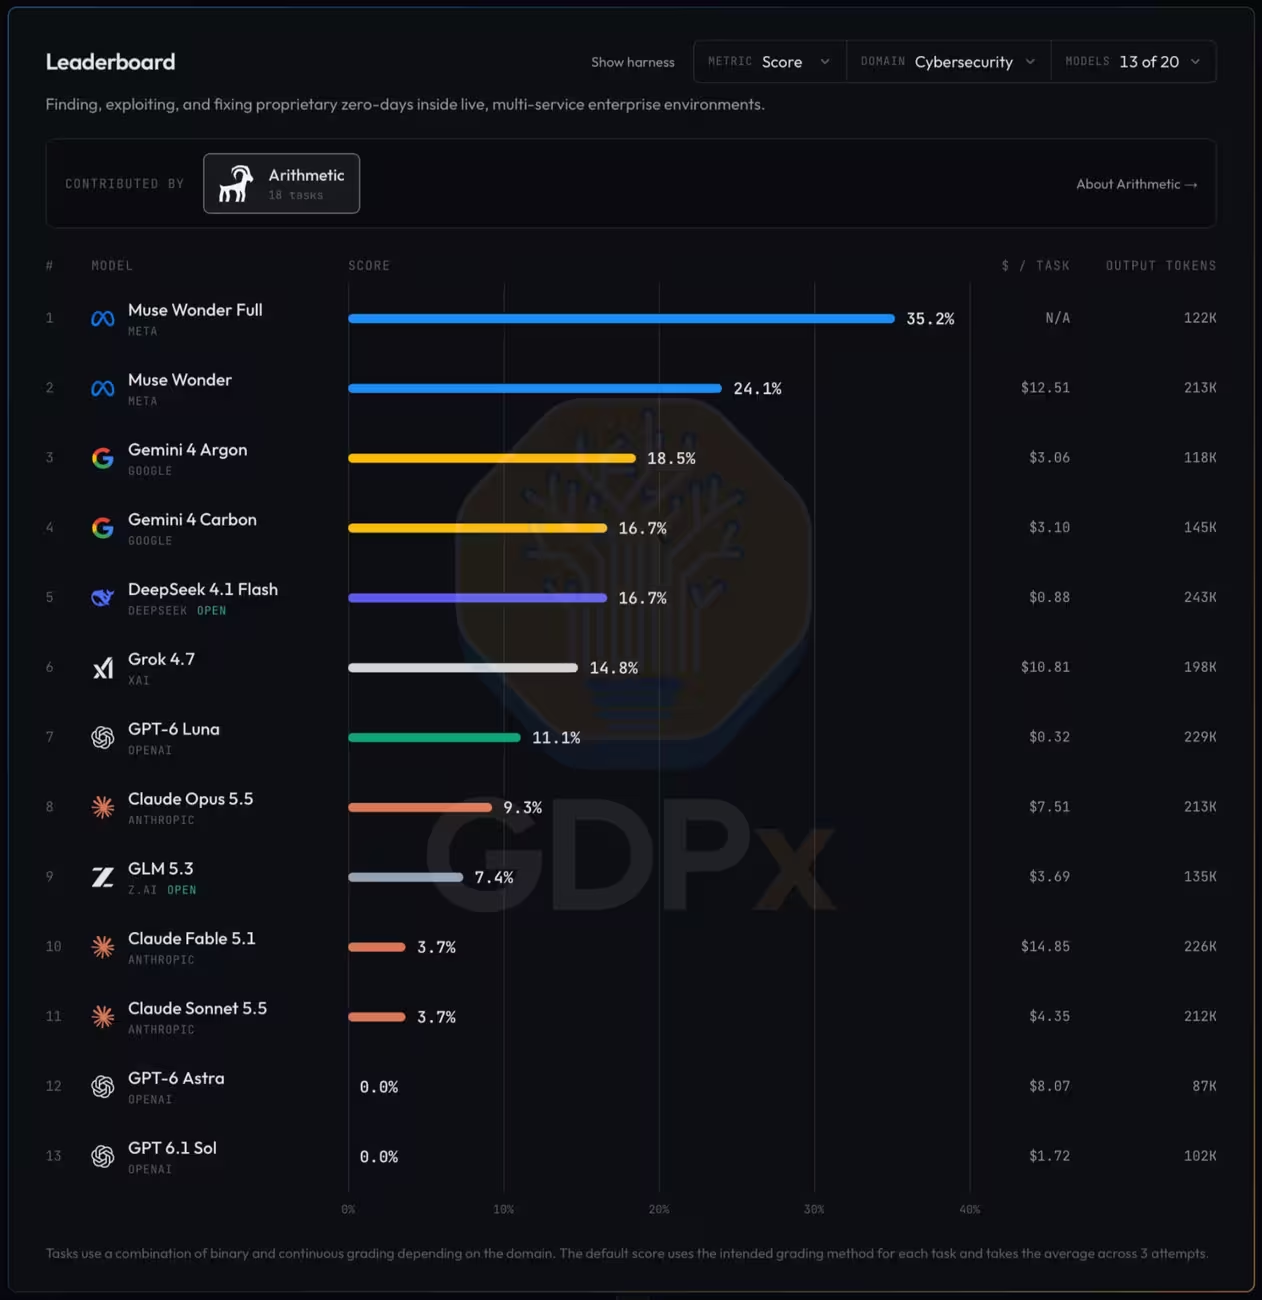
V úplném žebříčku GDPx má Opus 5.5 nejvyšší celkové skóre, zatímco Gemini 4 Carbon následuje s relativně malým rozdílem ve skóre. Rozdíl v nákladech je mnohem větší: SemiAnalysis uvádí přibližně 51 USD za úkol u Opus 5.5 oproti něco málo přes 16 USD za úkol u Gemini 4 Carbon. GPT-6 Astra od OpenAI se v tabulce objevuje následující, ale podle zprávy dosáhla nižšího skóre než Gemini 4 Carbon a vyšších průměrných nákladů, přibližně 54 USD za úkol.
Trojstranné porovnání zdůrazňuje rozdíl mezi lídrem v oblasti výkonu a lídrem v ekonomické hodnotě: Opus 5.5 vede v hrubém skóre, Gemini 4 Carbon se tomuto výkonu přibližuje za výrazně nižší náklady a GPT-6 Astra zaostává za oběma a navíc stojí za spuštění na úkol více.
Upravené pořadí a bezpečnostní filtry
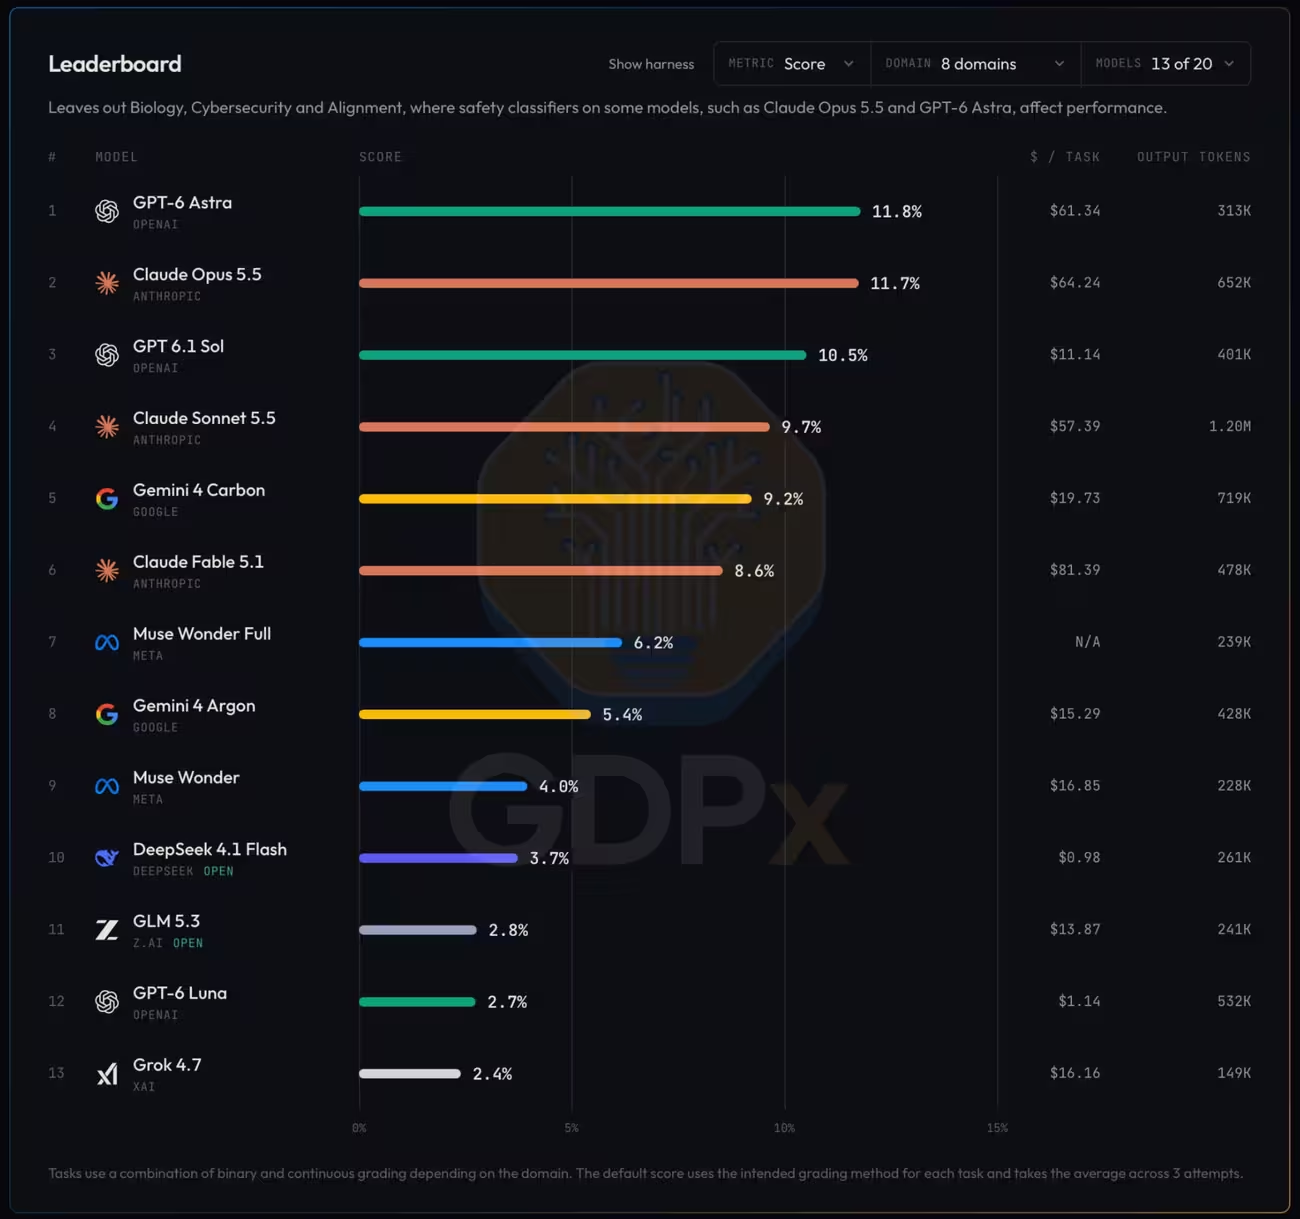
SemiAnalysis také zveřejnil upravené pořadí, které vylučuje úlohy z kybernetické bezpečnosti, biologie a úlohy týkající se sladění. Odstranění těchto tří oblastí přeskupilo vrchní pozice a umístilo GPT-6 Astra na první místo; GPT 6.1 Sol a Opus 5.5 se v upraveném seznamu rovněž umístily před Gemini 4 Carbon. Výzkumníci uvedli, že druhé uspořádání více odpovídá jejich subjektivnímu dojmu o schopnostech modelů.
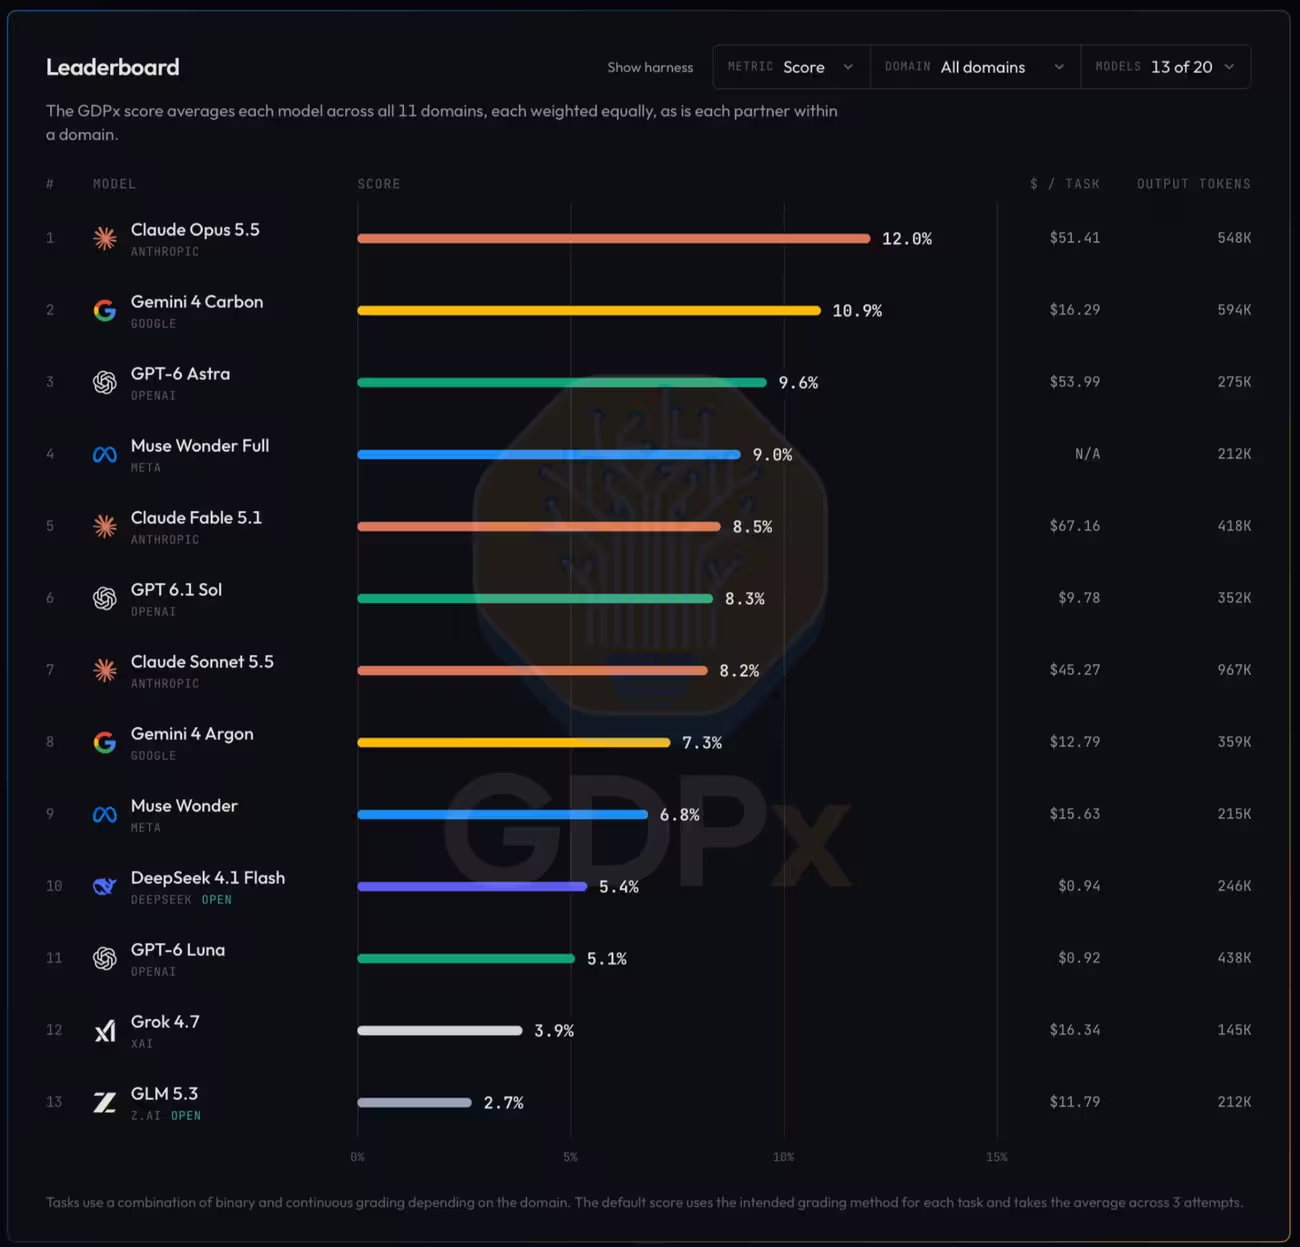
Zpráva upozorňuje, že bezpečnostní zábrany u modelů, jako je Claude a některé varianty GPT, mohou zabránit dokončení určitých úloh z oblasti kybernetické bezpečnosti, biologie nebo sladění. Tyto ochrany mohou ovlivnit hrubá skóre GDPx, takže skóre modelu někdy odráží jak technickou schopnost, tak i míru, do jaké mu je dovoleno reagovat na citlivé dotazy.
Předchozí průlomový model Googlu, Gemini 4 Argon, obsadil v obou, plném i upraveném, žebříčku osmé místo, umístil se nad Modelem Muse Wonder od Meta a pod Wonder Full. Náklady Argonu na úkol podle GDPx byly pouze o něco nižší než u Gemini 4 Carbon; malý rozdíl v ceně, spolu s vyšším umístěním Carbonu, naznačuje zlepšený poměr skóre k nákladům u novějšího modelu Googlu.
Při pohledu pouze na úlohy z kybernetické bezpečnosti se hierarchie mění: oba modely Googlu v této oblasti překonaly OpenAI a Anthropic, ale zaostaly za rodinou Muse od Meta, kterou GDPx uvádí jako nejsilnějšího hráče v kybernetické bezpečnosti s výrazným náskokem. SemiAnalysis dodává, že uváděné rozdíly v nákladech by mohly mít zásadní finanční dopad při testování ve vysokém objemu, opakovaných testech a nasazení v podnicích.
Napsat komentář
Komentáře
Zatím žádné komentáře. Buďte první.